SDLC ยุคใหม่ในวันที่เรา vibe coding
/ 17 min read
Table of Contents
ช่วงนี้ใครอยู่ในวงการเขียนโปรแกรมน่าจะได้ยินคำว่า “vibe coding” บ่อยขึ้นเรื่อยๆ คือการที่เราบอก AI ว่า อยากได้อะไร แล้วปล่อยให้มันไปจัดการเรื่อง เขียนยังไง เอง พอดีไปเจอ whitepaper ชื่อ The New SDLC with Vibe Coding ที่พูดเรื่องนี้ไว้น่าสนใจ (SDLC ย่อมาจาก software development life cycle คือวงจรการพัฒนาซอฟต์แวร์ ตั้งแต่เก็บ requirement ออกแบบ เขียน เทสต์ ดีพลอย ไปจนถึงดูแลหลังขึ้นจริง) เลยขอเอามาสรุป + เล่าความเห็นให้ฟังกัน
เกริ่นก่อนว่าเล่มนี้เป็นของ Google เขียนโดย Addy Osmani, Shubham Saboo และ Sokratis Kartakis ออกเดือนพฤษภาคม 2026 แจกผ่าน Kaggle เป็น “Day 1” ของคอร์ส 5 วัน (วันที่ 3 ว่าด้วย context engineering วันที่ 5 ว่าด้วยการทำของขึ้น production) ตัวเล่มยาว 51 หน้า ผมอ่านจบแล้วรู้สึกว่ามันไม่ใช่บทความเชียร์ AI ทั่วไป เพราะครึ่งเล่มหลังพูดเรื่องต้นทุนกับวินัยล้วนๆ
อ่านตัวเต็มได้เลย: โหลด PDF ทั้งเล่ม (51 หน้า) หรือ ไปที่หน้าต้นทางบน Kaggle
ประโยคเปิดเล่มของเขาสรุปทั้งเล่มได้ดีที่สุด คือ การเปลี่ยนแปลงครั้งใหญ่ที่สุดของวงการซอฟต์แวร์ตอนนี้ไม่ใช่ภาษาใหม่ เฟรมเวิร์กใหม่ หรือคลาวด์เจ้าใหม่ แต่คือการย้ายจาก “เขียนโค้ด” ไปเป็น “บอกเจตนา” แล้วเชื่อใจให้ระบบแปลเจตนานั้นเป็นซอฟต์แวร์ที่ทำงานได้
vibe coding คืออะไร
คำนี้มาจาก Andrej Karpathy (อดีตหัวหน้าทีม AI ของ Tesla) ที่โพสต์ไว้เดือนกุมภาพันธ์ 2025 ว่าเดี๋ยวนี้เขาเขียนโค้ดแบบ “ปล่อยไปตาม vibe” คือยอมจำนนให้กับ vibe ไปเลย ลืมไปว่ามีโค้ดอยู่ตรงนั้น พังตรงไหนก็ก็อป error กลับไปให้ AI แก้ แล้วคำนี้ก็ติดปากวงการมาตั้งแต่นั้น
หัวใจของมันสั้นมาก: เราบอกว่าจะสร้างอะไร ไม่ใช่บอกว่าสร้างยังไง เรื่อง “ยังไง” ปล่อยให้เครื่องจัดการ แล้วคนไปรับหน้าที่เรื่องเจตนา สถาปัตยกรรม และการตัดสินใจแทน
ที่น่าสนใจคือพอผ่านไปปีเดียว คำนี้ถูกใช้กว้างจนเริ่มไม่มีความหมาย ซีเนียร์ที่ใช้ AI เขียนฟีเจอร์ที่สเปกชัดอยู่แล้วก็เรียก vibe coding ส่วนทีมที่วางสถาปัตยกรรมมาอย่างดีแล้วให้ agent ไปลงมือก็เรียก vibe coding ต้นปี 2026 Karpathy เลยออกมายอมรับเองว่ากรอบเดิมมันแคบไป และเสนอคำใหม่คือ agentic engineering สำหรับปลายทางฝั่งที่มีวินัย
whitepaper บอกว่านี่คือการเปลี่ยนแปลงครั้งใหญ่ที่สุดของวงการตั้งแต่มีภาษาโปรแกรมระดับสูงเลยทีเดียว และมันไม่ใช่เรื่องอนาคตไกลๆ แล้ว ตัวเลขที่เขายกมาคือต้นปี 2026 นักพัฒนามืออาชีพ 85% ใช้ AI coding agent เป็นประจำ 51% ใช้ทุกวัน และประมาณ 41% ของโค้ดใหม่ทั้งหมดมาจาก AI
ถ้าย้อนดูเส้นทางจะเห็นว่ามันค่อยๆ ขยับมาทีละขั้น ไม่ได้กระโดดมาทีเดียว
| ช่วงเวลา | ความสามารถ |
|---|---|
| ~2021 | autocomplete เดาตัวอักษรถัดไปให้ |
| ~2022 | inline suggestion เติมทั้งฟังก์ชันจากชื่อฟังก์ชัน |
| ~2023 | แชตบอกฟีเจอร์เป็นภาษาคน แล้วได้โค้ดที่ใช้ได้กลับมา |
| ~2024-25 | coding agent แก้หลายไฟล์ เรียก tool รันโค้ด แก้ตัวเองเป็นรอบๆ |
| ~2025-26 | agent อิสระ clone repo วางแผน รันในแซนด์บ็อกซ์ รันเทสต์ เปิด pull request เองโดยคนไม่ต้องพิมพ์โค้ดสักบรรทัด |
แต่ละขั้นไม่ได้ทิ้งของเก่า แค่ยกเพดานว่าวิศวกรคนเดียวทำอะไรได้บ้างขึ้นไปอีก
สเปกตรัม: จาก vibe coding ถึง agentic engineering
จุดที่ผมว่าเป็นแก่นของเล่มนี้เลยคือ เขาไม่ให้มองว่า vibe coding กับ agentic engineering เป็นของคนละอย่างที่ต้องเลือกข้าง แต่ให้มองเป็น สเปกตรัมเดียวกัน ตัวแปรสำคัญไม่ใช่ “ใช้ AI หรือเปล่า” แต่คือ มีโครงสร้าง การตรวจสอบ และวิจารณญาณของคนห่อหุ้มผลลัพธ์ของ AI มากแค่ไหน
| มิติ | Vibe Coding | Structured AI-Assisted | Agentic Engineering |
|---|---|---|---|
| บอกเจตนายังไง | prompt ภาษาคนแบบสบายๆ | prompt ละเอียด มีตัวอย่างและข้อจำกัด | สเปกเป็นทางการ เอกสารสถาปัตยกรรม ไฟล์ memory |
| ตรวจสอบยังไง | ”ดูเหมือนจะใช้ได้นะ” | เทสต์เอง สุ่มตรวจ | ชุดเทสต์อัตโนมัติ ด่านใน CI/CD ใช้ LM เป็นกรรมการ |
| เข้าใจโค้ดแค่ไหน | แทบไม่อ่านโค้ดที่ได้มา | อ่านเฉพาะเส้นทางสำคัญ | รีวิวสถาปัตยกรรมทั้งหมด ปล่อยรายละเอียดให้ AI |
| เจอ error แล้วทำไง | ก็อป error ไปแปะให้ AI | คนหาต้นเหตุ AI ลงมือแก้ | agent วินิจฉัยเองในขอบเขตที่กำหนด คนดูเรื่องสถาปัตยกรรม |
| เหมาะกับงานแบบไหน | ต้นแบบ สคริปต์ งานส่วนตัว hackathon | ฟีเจอร์ในโค้ดเบสที่มีอยู่แล้ว | ระบบ production งานระดับทีม |
| ความเสี่ยง | สูง รับได้ถ้าเป็นโค้ดใช้แล้วทิ้ง | กลาง มีคนตัดสินใจที่จุดสำคัญ | ต่ำ มีการตรวจสอบเป็นระบบทุกขั้น |
เขายกตัวอย่างที่เห็นภาพมาก คือถ้าไปบอก CTO ว่าทีมกำลัง vibe coding ระบบตัดเงินอยู่ มันควรทำให้เขาสะดุ้งทันที แต่ถ้าบอกว่าทีมทำ agentic engineering โดยให้ AI ลงมือภายใต้ข้อจำกัดที่คนออกแบบ และมี test coverage คุมความถูกต้องอยู่ นั่นคือคนละบทสนทนากันเลย
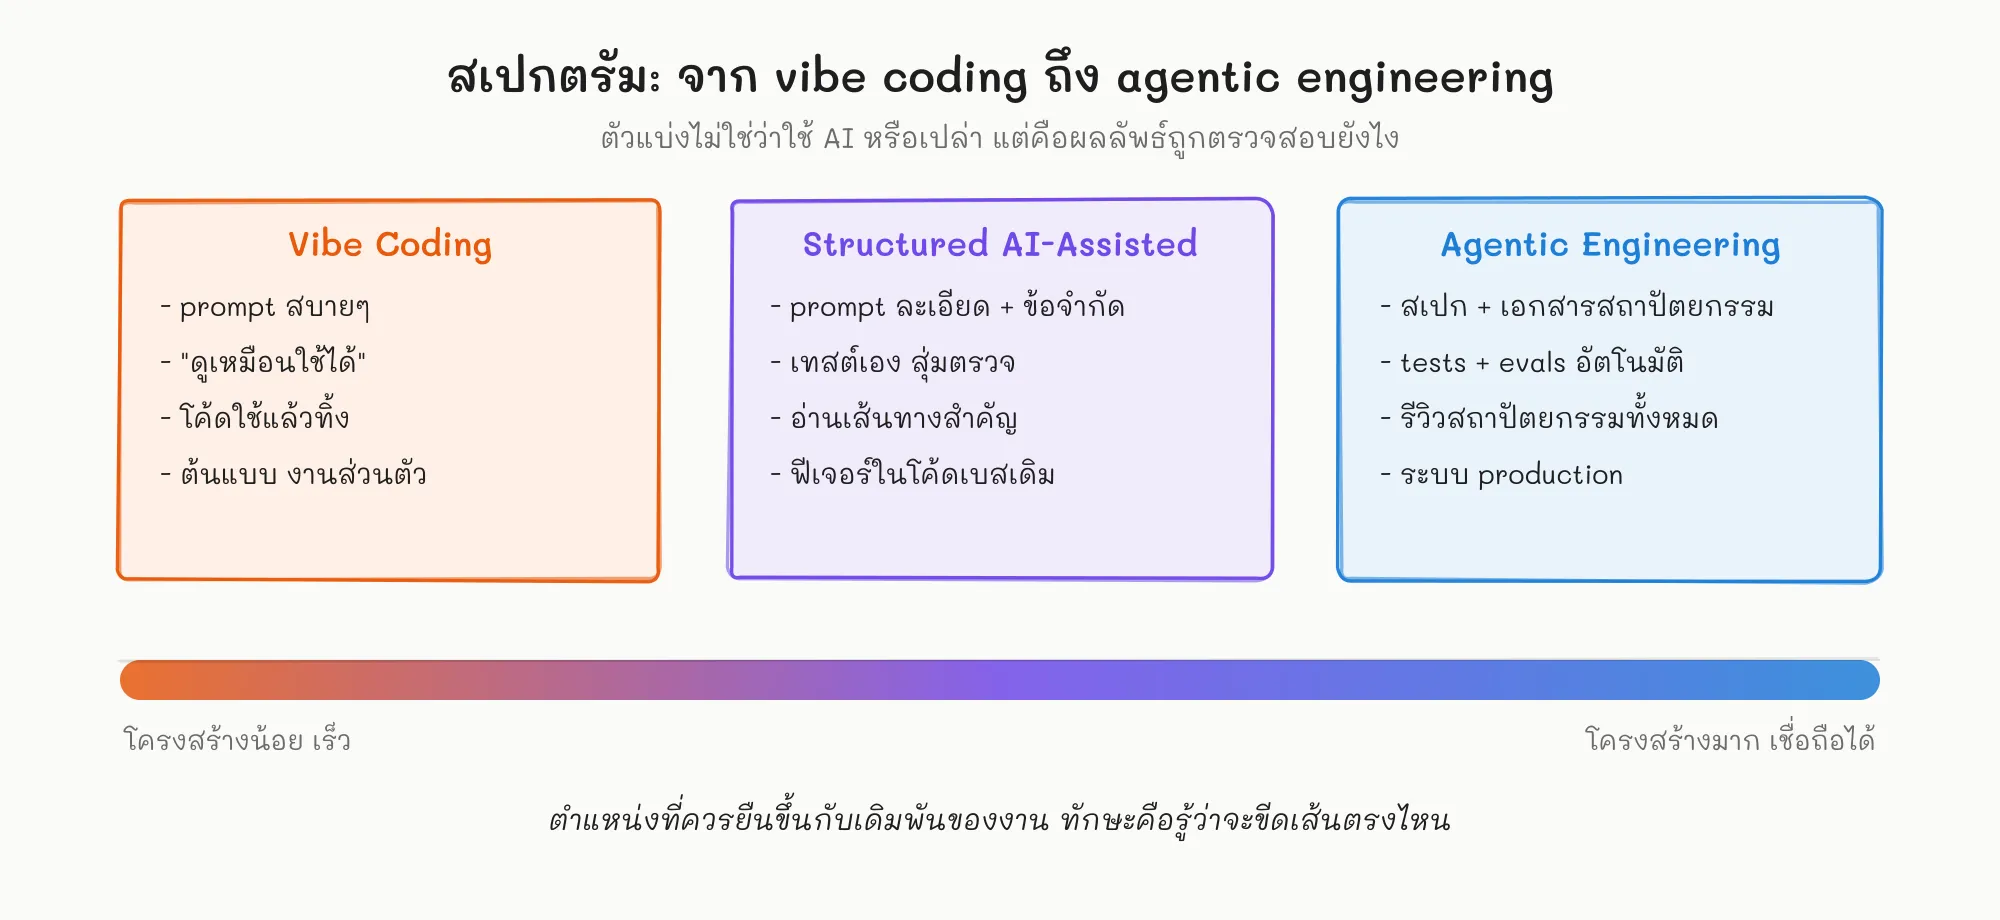
ตัวแบ่งที่ชัดที่สุดระหว่างสองปลายคือ วิธีตรวจผลลัพธ์ ฝั่ง vibe coding การตรวจเป็นของแถม รันดูแล้วรู้สึกว่าใช้ได้ก็จบ ส่วนฝั่ง agentic engineering ใช้สองกลไกคู่กัน คือ tests ตรวจส่วนที่ผลลัพธ์ตายตัว (ใส่ค่านี้ต้องได้ค่านั้น) กับ evals ตรวจส่วนที่ไม่ตายตัว (agent เดินทางถูกทางไหม เลือก tool ถูกไหม คำตอบสุดท้ายผ่านเกณฑ์คุณภาพหรือเปล่า) เขาบอกตรงๆ ว่าถ้าไม่มีทั้งสองอย่าง ต่อให้ prompt ประณีตแค่ไหนก็ยังนับเป็น vibe coding อยู่ดี
ตำแหน่งที่ควรยืนบนสเปกตรัมขึ้นกับเดิมพันของงาน ต้นแบบที่ทำเล่นวันหยุดจะ vibe เต็มที่ก็ได้ แต่ API ที่จัดการธุรกรรมการเงินต้องใช้ agentic engineering งานจริงส่วนใหญ่อยู่ตรงกลาง และทักษะที่ต้องมีคือรู้ว่าจะขีดเส้นตรงไหนของแต่ละงาน
context engineering: ทักษะจริงที่ต้องฝึก
พอวงการโตขึ้นก็เจอความจริงข้อหนึ่ง คือคุณภาพของโค้ดที่ AI เขียนไม่ได้ขึ้นกับความฉลาดของ prompt เท่ากับ คุณภาพของบริบทที่เราป้อนให้ เลยเกิดคำว่า context engineering ขึ้นมาแทนที่ prompt engineering
whitepaper แบ่งบริบทที่ agent ต้องมีเป็น 6 ประเภท
- Instructions บทบาท เป้าหมาย และขอบเขตที่ทำได้ทำไม่ได้
- Knowledge เอกสาร ไดอะแกรมสถาปัตยกรรม ข้อมูลเฉพาะโดเมน
- Memory ทั้งความจำระยะสั้น (เพิ่งเกิดอะไรขึ้นในเซสชัน) และระยะยาว (โปรเจกต์นี้คืออะไร)
- Examples ตัวอย่างพฤติกรรมแบบ few-shot และแพตเทิร์นอ้างอิงในโค้ดเบส
- Tools นิยามของ API สคริปต์ และบริการภายนอกที่เรียกใช้ได้
- Guardrails ข้อห้ามแข็งๆ กฎการจัดรูปแบบ และการตรวจความปลอดภัย
จากนั้นเป็นการตัดสินใจเชิงวิศวกรรมว่าอะไรควรเป็น static context (โหลดตลอด เช่น system instruction, ไฟล์กฎอย่าง AGENTS.md CLAUDE.md GEMINI.md, memory ระดับ global) กับอะไรควรเป็น dynamic context (โหลดตอนต้องใช้ เช่น skill ที่ตรงกับงาน ผลลัพธ์จาก tool เอกสารที่ดึงมาตอนนั้นด้วย RAG คือการค้นเอกสารมาแปะให้โมเดลอ่านเฉพาะตอนต้องใช้)
เส้นแบ่งนี้มีต้นทุนจริง static context แพงเพราะทุก token ถูกส่งไปทุกครั้งที่คุย ไม่ว่าจะเกี่ยวกับงานตรงหน้าหรือไม่ ใส่เยอะไปก็เปลืองและกลบสัญญาณสำคัญ ใส่น้อยไป agent ก็ลืมกฎที่ห้ามลืม whitepaper เลยแนะนำให้ปฏิบัติกับเส้นแบ่งนี้เหมือนการตัดสินใจเชิงสถาปัตยกรรม คือมีคนรีวิวและมีเวอร์ชันเหมือนโค้ดทั่วไป
แพตเทิร์นที่เขายกว่าดีที่สุดสำหรับ dynamic context คือ Agent Skills คือแพ็กความรู้เชิงวิธีทำที่ agent โหลดเฉพาะตอนงานตรงกับมัน ผลคือ agent เป็น generalist ตัวเบาที่แปลงร่างเป็น specialist ได้ตามงาน พกความสามารถได้หลายสิบอย่างโดยจ่ายค่า token เฉพาะอันที่กำลังใช้จริง ถ้าใครสนใจสาย skill ผมเคยรวมไว้ในโพสต์ มัดรวม Agent Skills สำหรับงาน UX/UI แล้วเหมือนกัน
ประโยคที่ผมชอบที่สุดในหัวข้อนี้คือ คำถามที่ควรถามไม่ใช่ “จะหลอก AI ให้เขียนโค้ดดีๆ ได้ยังไง” แต่คือ “คนที่เพิ่งเข้าทีมต้องรู้อะไรบ้างถึงจะทำงานนี้ได้ดี แล้วเราจะเข้ารหัสความรู้นั้นให้ AI ใช้ได้ยังไง”
Agent = Model + Harness
อีกกรอบคิดที่ผมว่ามีประโยชน์มากคือเรื่อง harness เวลา agent ทำอะไรพัง คนส่วนใหญ่โทษโมเดลก่อนเสมอ ทั้งที่โมเดลเป็นแค่หนึ่ง input ของระบบที่กำลังรันอยู่
ทุกอย่างที่ห่อโมเดลไว้คือ harness ได้แก่
- คำสั่งและไฟล์กฎ ตัวบอกว่า agent เป็นใคร แคร์อะไร ห้ามทำอะไร (
AGENTS.md,CLAUDE.md, ไฟล์ skill, prompt ของ sub-agent) - Tools ฟังก์ชัน MCP server (มาตรฐานกลางที่ให้ agent ต่อกับเครื่องมือภายนอก) และ API ที่เรียกได้ รวมถึงคำอธิบายว่าควรเรียกเมื่อไหร่
- แซนด์บ็อกซ์และสภาพแวดล้อมรัน โค้ดที่ agent เขียนไปรันที่ไหน เข้าถึงอะไรได้ อะไรไม่ได้
- ตรรกะ orchestration การแตก sub-agent การเลือกโมเดล การส่งงานต่อระหว่างตัวเชี่ยวชาญ
- Guardrails หรือ hooks โค้ดตายตัวที่รันตามจุดสำคัญ เช่น ก่อนเรียก tool หลังแก้ไฟล์ ก่อน commit
- Observability log, trace, eval, การวัดต้นทุนและ latency ถ้าไม่มีส่วนนี้จะไม่มีทางรู้ว่า agent ทำได้ดีหรือกำลังค่อยๆ เพี้ยน
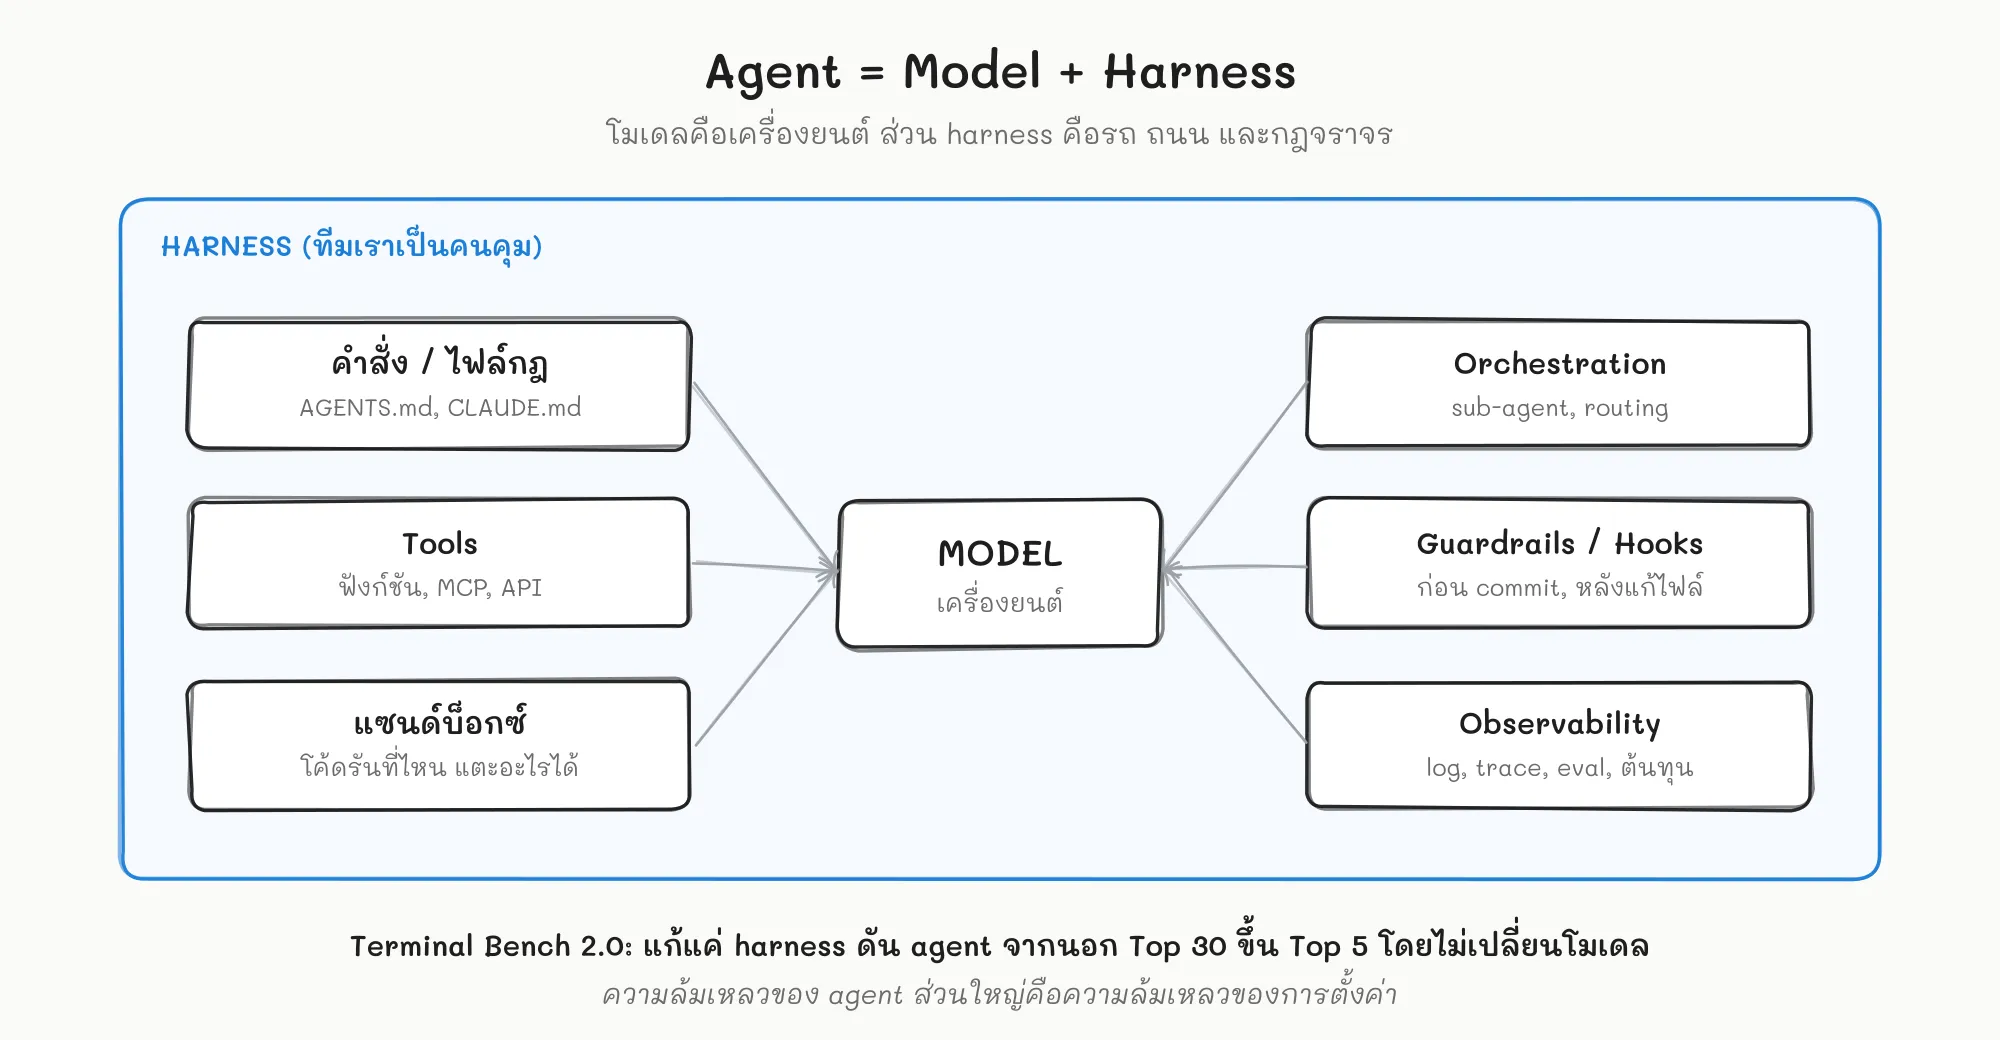
หลักฐานว่า harness สำคัญแค่ไหนคือตัวเลขจาก benchmark สาธารณะ บน benchmark ชื่อ Terminal Bench 2.0 มีทีมหนึ่งดัน coding agent จากนอก Top 30 ขึ้นมา Top 5 ได้ โดยแก้แค่ harness ไม่เปลี่ยนโมเดลเลย และอีกงานของ LangChain บน benchmark เดียวกัน ก็ดันคะแนนขึ้น 13.7 จุดด้วยการปรับแค่ system prompt, tool และ middleware รอบโมเดลเดิม
สรุปเป็นประโยคเดียวคือ ความล้มเหลวของ agent ส่วนใหญ่ ถ้าดูตรงๆ คือความล้มเหลวของการตั้งค่า ไม่ใช่ของโมเดล ซึ่งข่าวดีคือส่วนนี้เป็นพื้นที่ที่ทีมเราคุมเองได้ ไม่ต้องรอเจ้าของโมเดล
SDLC เปลี่ยนไปยังไงในแต่ละเฟส
ก่อนจะไปดูว่าอะไรเปลี่ยน ขอทวนของเดิมก่อน SDLC แบบที่เรียนกันมาคือวงจร 6 เฟส วนกันเป็นวงกลม จบเฟสสุดท้ายก็กลับไปเริ่มรอบใหม่
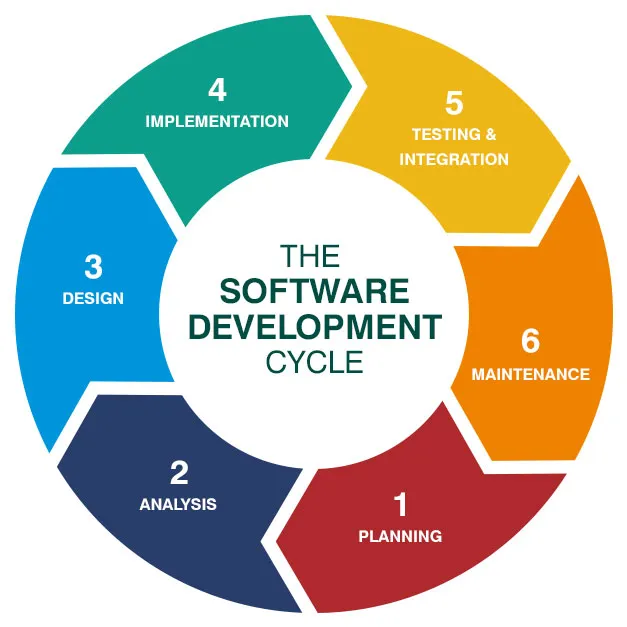
vibe coding ไม่ได้ล้มวงจรนี้ทิ้ง แต่มันบีบทุกเฟสให้สั้นลง แบบไม่เท่ากัน งาน implement ที่เคยใช้เป็นสัปดาห์เหลือไม่กี่ชั่วโมง แต่การเก็บ requirement การออกแบบ และการตรวจสอบยังเดินตามจังหวะมนุษย์อยู่ ผลคือมันไม่ใช่ SDLC เดิมที่เร็วขึ้น แต่เป็น workflow คนละแบบ ที่เส้นแบ่งระหว่างเฟสเริ่มเบลอ และรอบ iteration ลดจากสัปดาห์เหลือนาที
เก็บ requirement และวางแผน เฟสนี้เคยเป็นจุดที่ช่องว่างระหว่างเจตนากับสิ่งที่สร้างจริงกว้างที่สุด ตอนนี้ AI เข้ามาช่วยร่าง user story จาก brief ชี้ edge case ที่คนมองข้าม ปั้น API schema จากคำอธิบายภาษาคน และทำต้นแบบกดเล่นได้จากเอกสารสเปก แล้ว requirement ก็เลิกเป็นเอกสารที่ส่งต่อกันไปมา กลายเป็นบทสนทนาที่ให้ทั้งสเปกและโค้ดตั้งต้นออกมาพร้อมกัน ข้อสังเกตของเขาคือ คุณภาพของสเปกกลายเป็นคอขวดใหม่
ออกแบบสถาปัตยกรรม ยังเป็นเฟสที่ติดอยู่กับคนมากที่สุด และเขาบอกว่าสมควรแล้ว เพราะการตัดสินใจเชิงสถาปัตยกรรมคือเรื่องของ trade-off (consistency กับ availability, ความซับซ้อนกับความยืดหยุ่น, สร้างเองหรือซื้อ) ซึ่งขึ้นกับบริบทธุรกิจและข้อจำกัดขององค์กรที่ AI ยังจับไม่ได้ทั้งหมด แต่พอ ตัดสินใจแล้ว AI เก่งมากในการลงมือให้ตรงตามนั้น scaffold ทั้งแอป สร้างแพตเทิร์นให้สม่ำเสมอทุกโมดูล บทบาทคนเลยขยับจากพิมพ์ boilerplate ไปเป็นคนตัดสินใจและเขียนบันทึกโครงสร้างที่ boilerplate นั้นสะท้อนออกมา
ลงมือเขียน ตัวเลขจากผลสำรวจอุตสาหกรรมคือ productivity ขึ้น 25 ถึง 39% แต่ที่ผมว่าซื่อสัตย์ดีคือเขาเอางานของ METR มาถ่วงด้วย งานนั้นพบว่านักพัฒนาที่มีประสบการณ์ซึ่งใช้ AI ช่วย กลับ ใช้เวลานานขึ้น 19% ในบางงาน เพราะเวลาหมดไปกับการตรวจ แก้ และดีบั๊กสิ่งที่ AI เขียน สรุปคือ AI ไม่ได้ลบงาน implement ทิ้ง แต่แปลงมันจาก “เขียน” เป็น “ตรวจ ชี้ทาง และยืนยันความถูกต้อง”
เทสต์และ QA ต้องตรวจสองชั้น คือ output evaluation (ของที่ได้มาถูกไหม คอมไพล์ผ่านไหม เทสต์เขียวไหม) กับ trajectory evaluation (มันไปถึงคำตอบนั้นได้ยังไง เรียก tool อะไรบ้าง เหตุผลระหว่างทางสมเหตุสมผลไหม) ที่ต้องมีทั้งคู่เพราะคำตอบที่ดูลื่นไหลแต่ข้ามขั้นตอนตรวจสอบไป อันตรายกว่าคำตอบที่พังให้เห็นตรงๆ อีกมุมที่เปลี่ยนคือ เทสต์กับ eval กลายเป็นวิธีสื่อสารเจตนากับ AI ชุด eval ที่เขียนดีบอก AI ได้ตรงกว่า prompt ยาวๆ ว่า “ถูกต้อง” แปลว่าอะไร
รีวิวและดีพลอย AI ทำหน้าที่ผู้ตรวจด่านแรกได้ดี จับบั๊ก จับช่องโหว่ จับปัญหา performance ก่อนถึงมือคน ไม่ได้แทนการรีวิวของคน เพราะเรื่องดีไซน์ ความง่ายในการดูแลระยะยาว และความสอดคล้องเชิงกลยุทธ์ยังต้องใช้วิจารณญาณ แต่ช่วยลดภาระทางความคิดของผู้รีวิวได้เยอะ ส่วน pipeline ก็เริ่มรู้จัก AI มากขึ้น ทั้งเฝ้าสุขภาพหลังดีพลอย โรลแบ็กอัตโนมัติเมื่อมีปัญหา และประเมินความเสี่ยงจากลักษณะของการเปลี่ยนแปลง
ดูแลและต่อยอด เขาบอกว่านี่คือเฟสที่คนประเมินค่าต่ำที่สุด โค้ดเก่าที่เคย “แตะไม่ได้เพราะคนเขียนไปแล้ว” ตอนนี้ agent อ่านทั้งโค้ดเบส เข้าใจแพตเทิร์น หาไฟล์ที่เกี่ยวข้อง แล้วแก้โดยเคารพสถาปัตยกรรมเดิมได้ งานอย่างย้ายเฟรมเวิร์ก อัปเดต API ที่ deprecated หรือรื้อชุดเทสต์ให้ทันสมัย ซึ่งเมื่อก่อนน่าเบื่อและเสี่ยงจนไม่มีใครทำ กลายเป็นงานที่ทำได้จริง
factory model: ผลงานของเราคือระบบที่ผลิตโค้ด
กรอบคิดที่มัดทุกอย่างเข้าด้วยกันคือสิ่งที่เขาเรียกว่า factory model ใจความคือ ผลงานหลักของนักพัฒนาไม่ใช่โค้ดอีกต่อไป แต่คือ ระบบที่ผลิตโค้ด ซึ่งประกอบด้วยสเปกและบริบทที่บอกว่าต้องสร้างอะไร, agent ที่แปลงสเปกเป็นของจริง, เทสต์และด่านคุณภาพที่ยืนยันความถูกต้อง, feedback loop ที่ส่งความผิดพลาดกลับไปให้ agent แก้ และ guardrails ที่กันไม่ให้ agent ออกนอกลู่
เขาเปรียบว่าผู้จัดการโรงงานไม่ได้ประกอบสินค้าเองทีละชิ้น แต่ออกแบบสายพานและคุมคุณภาพ ความสำเร็จมาจากการบอกเกณฑ์ความสำเร็จให้ agent แทนที่จะสั่งทีละขั้น แล้วปล่อยให้มันวนแก้เอง
conductor กับ orchestrator: สองโหมดของคนทำงานกับ agent
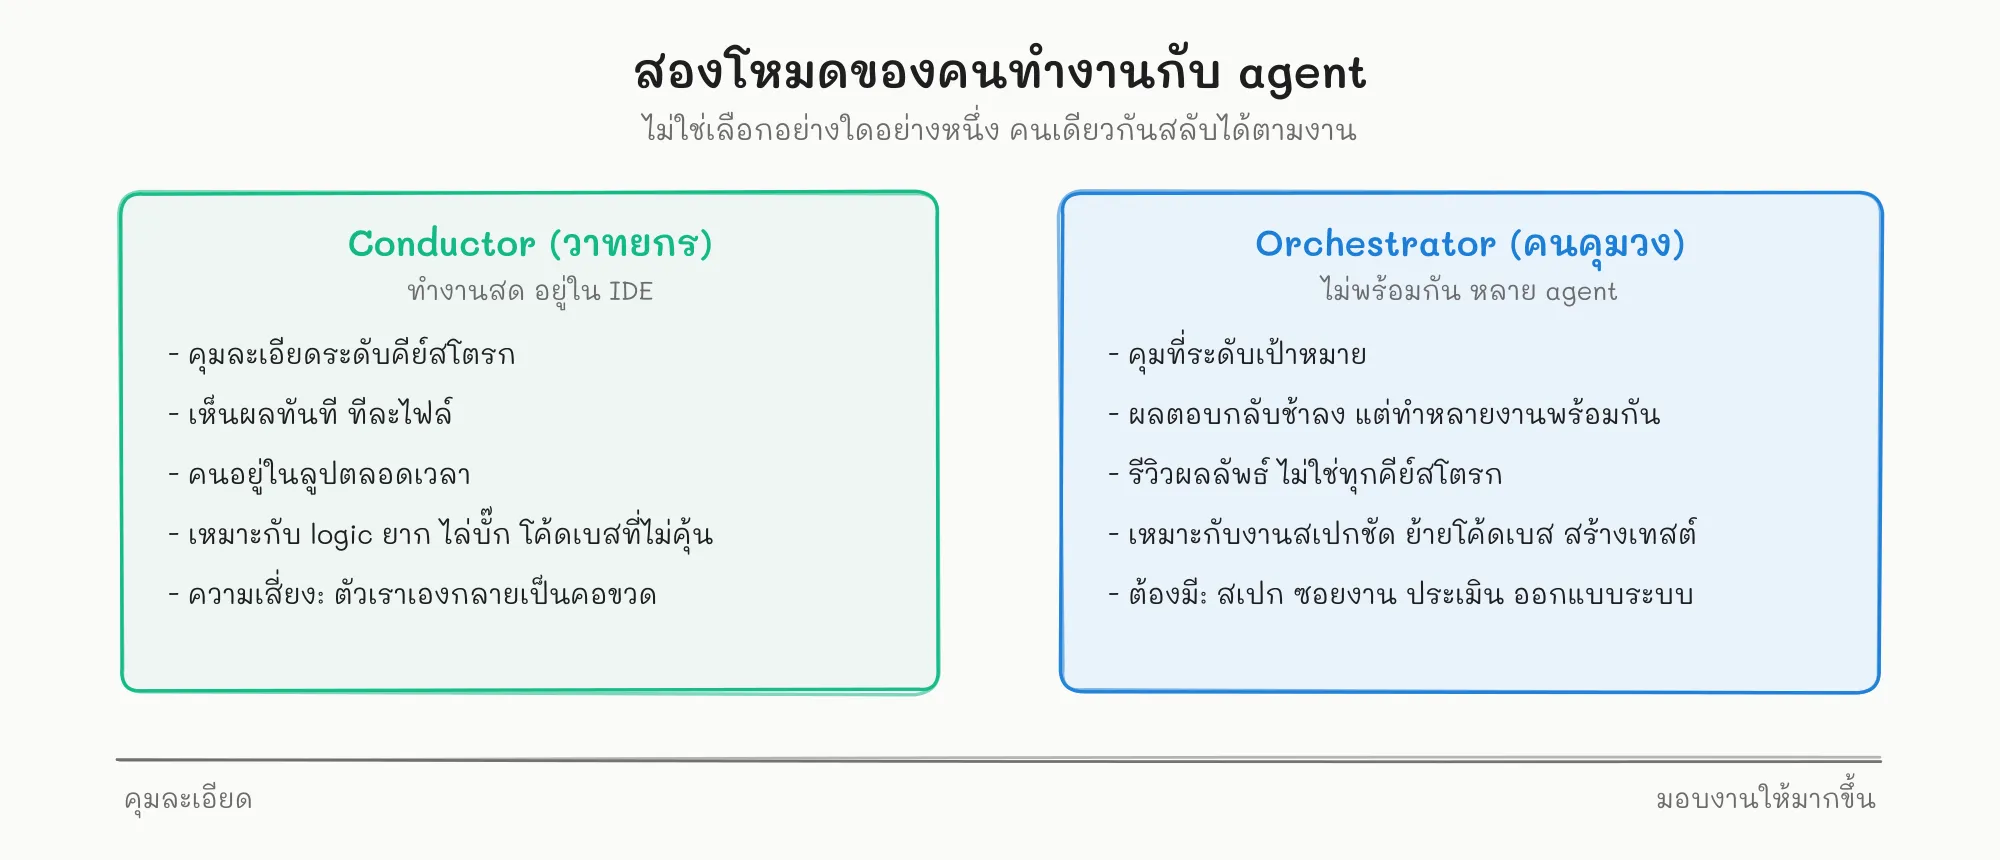
จุดที่ผมว่าโดนที่สุดคือบทบาทของ dev ที่เปลี่ยนไป whitepaper แบ่งเป็นสองโหมดที่คนเดียวกันสลับไปมาได้ ไม่ใช่ต้องเลือกอย่างใดอย่างหนึ่ง
Conductor (วาทยกร) คือทำงานสดกับ AI แบบ pair programming อยู่ใน IDE เห็นโค้ดโผล่มาทีละบรรทัด คอยชี้และแก้ทันที คุมละเอียดระดับ keystroke เหมาะกับ logic ซับซ้อน การไล่บั๊กยากๆ หรือตอนอยู่ในโค้ดเบสที่ไม่คุ้น ข้อดีคือยังรู้สึกว่าเข้าใจและควบคุมได้ทุกอย่าง ข้อเสียคือตัวเราเองกลายเป็นคอขวด เพราะถ้าต้องสั่งทุกจังหวะ throughput ที่ได้จาก AI ก็จำกัดอยู่แค่ความเร็วของเรา
Orchestrator (คนคุมวง) คือทำงานที่ระดับนามธรรมสูงกว่า ตั้งเป้าหมาย มอบงานให้ agent แล้วไปตรวจผลทีหลัง agent อาจทำงานอยู่เบื้องหลังพร้อมกันหลายตัวคนละส่วนของโค้ดเบส เราแวะมาดูเป็นระยะ รีวิวผลลัพธ์ แล้วปรับทิศ เหมาะกับงานที่นิยามชัด เช่น แก้บั๊กที่รู้สาเหตุ ทำฟีเจอร์ตามแพตเทิร์นที่มีอยู่ ย้ายโค้ดเบส หรือสร้างชุดเทสต์
โหมดหลังเรียกร้องทักษะคนละชุดกับที่เราคุ้น คือไม่ได้วัดกันที่ความแม่นเรื่อง syntax แต่วัดกันที่
- Specification นิยามงานให้ชัดพอที่ agent ทำได้โดยไม่ต้องเดา
- Decomposition ซอยงานใหญ่ให้เป็นก้อนขนาดที่ agent รับไหว
- Evaluation ดูออกเร็วๆ ว่าผลลัพธ์ผ่านมาตรฐานหรือยัง
- System design ออกแบบข้อจำกัด เทสต์ และ feedback loop ที่ทำให้ agent ทำงานได้ต่อเนื่อง
ฟังดูเหมือนสบายขึ้น แต่จริงๆ มันเรียกร้อง “ความเป็นซีเนียร์” มากกว่าเดิมด้วยซ้ำ เพราะต้องมองภาพกว้าง รู้ว่าอะไรดีอะไรไม่ดี และที่สำคัญคือต้อง อธิบายสิ่งที่อยากได้ให้ชัด ทั้งกับคนและกับเครื่อง ทักษะการสื่อสารกลายเป็นทักษะทางเทคนิคไปเลย
ปัญหา 80%
อีกเรื่องที่ควรรู้ก่อนคาดหวังสูงคือสิ่งที่เขาเรียกว่า the 80% problem คือ agent ปั่นโค้ดของฟีเจอร์หนึ่งได้เร็วมากประมาณ 80% แต่ 20% ที่เหลือ ซึ่งคือ edge case, การจัดการ error, จุดเชื่อมต่อกับระบบอื่น และเงื่อนไขความถูกต้องที่ละเอียดอ่อน ต้องใช้ความรู้เชิงบริบทลึกที่โมเดลปัจจุบันมักไม่มี
ที่แย่กว่านั้นคือธรรมชาติของ error เปลี่ยนไป จากเดิมที่ผิด syntax แล้วเห็นทันที กลายเป็นความผิดพลาดเชิงแนวคิดที่แนบเนียนกว่า เช่น สมมติฐานผิดเกี่ยวกับ business logic, ไม่ถามเมื่อโจทย์กำกวม, ลืม edge case, หรือเลือกทางสถาปัตยกรรมที่สร้างภาระดูแลระยะยาว ความผิดพลาดพวกนี้จับยากเพราะโค้ด “ดูถูกต้อง” และอาจผ่านเทสต์พื้นฐานไปได้ด้วย
คนที่รับมือกับเรื่องนี้ได้ดีมีท่าประจำอยู่ท่าหนึ่ง คือใช้ AI กับสิ่งที่มันเก่ง (ลงมืองานที่สเปกชัด) แล้วเก็บสมาธิของตัวเองไว้กับสิ่งที่ AI ยังอ่อน (โจทย์กำกวม trade-off เชิงสถาปัตยกรรม และการยืนยันความถูกต้อง) พูดอีกแบบคือไม่ได้พยายามเร็วขึ้นด้วยการรับทุกอย่างที่ AI ให้มา แต่เร็วขึ้นด้วยการเอาความเชี่ยวชาญไปลงตรงจุดที่มันสร้างผลต่างจริง
agent อยู่ตรงไหนในวันทำงานของเรา
whitepaper แบ่ง coding agent ตามที่มันไปโผล่ในชีวิตประจำวันเป็นสามที่ และบอกว่าคนส่วนใหญ่ใช้ทั้งสามแบบในวันเดียวกัน
- ใน editor เติมโค้ดบรรทัดถัดไป แผงแชตที่อธิบายหรือแก้โค้ดตรงนั้น เหมาะตอนกำลังเขียนอยู่แล้วไม่อยากหลุดโฟลว์ (GitHub Copilot, Cursor, Windsurf, JetBrains AI Assistant)
- ใน terminal เปิดจาก command line โยนเป้าหมายเป็นภาษาคนให้ แล้วปล่อยให้มันทำงานข้ามไฟล์ รันเครื่องมือ รันเทสต์ แล้ววนแก้ตามผล เขาบอกว่านี่คือที่ที่ vibe coding จริงจังเกิดขึ้นในตอนนี้ (Claude Code, Codex CLI, Antigravity CLI, Open Code, Cline)
- ในเบื้องหลัง รับงานไปทำเองในแซนด์บ็อกซ์บนคลาวด์เป็นชั่วโมง แล้วส่งผลออกมาเป็น pull request ให้มารีวิวทีหลัง (Google Jules, GitHub Copilot agent mode, background agent ของ Cursor)
เกณฑ์เลือกไม่ใช่ว่าตัวไหนอิสระที่สุด แต่คืองานตรงหน้าเป็นแบบไหน งานที่อธิบายจบในย่อหน้าเดียวแล้วเดินหนีได้ เช่น แก้บั๊กที่รู้สาเหตุ สร้างชุดเทสต์ หรือย้ายเฟรมเวิร์ก เหมาะกับ agent เบื้องหลัง ส่วนงานที่ต้องเข้าใจทุกการเปลี่ยนแปลงระหว่างทางเหมาะกับ editor หรือ terminal มากกว่า
เศรษฐศาสตร์: ของถูกตอนเริ่ม แพงตอนดูแล
หัวข้อนี้ผมว่าเป็นของแถมที่มีค่าที่สุดในเล่ม เพราะส่วนใหญ่เวลาพูดเรื่อง AI กับการพัฒนาซอฟต์แวร์ จะจบแค่ “เขียนเร็วขึ้นแค่ไหน” แต่เขาชวนมองที่ ต้นทุนรวมตลอดอายุ (TCO) แทน โดยแยกเป็นต้นทุนตั้งต้น (CapEx) กับต้นทุนที่ต้องจ่ายไปเรื่อยๆ (OpEx)
vibe coding = CapEx ต่ำ OpEx สูง เริ่มแทบไม่ต้องลงทุนอะไรเลย มีค่าสมาชิกรายเดือนกับ prompt ไม่กี่บรรทัดก็เริ่มได้ แต่ต้นทุนที่ตามมาทบต้นคือ
- ค่า token ที่เผาไป เพราะนิสัยโยนไฟล์กองใหญ่เข้า context แล้ววนถาม AI ให้แก้ของที่มันเพิ่งทำพลาดเอง พออัตราสำเร็จตั้งแต่ครั้งแรกต่ำ ก็ยิ่งวนยิ่งจ่าย
- ภาษีการดูแล โค้ดที่เกิดจากการ prompt ไปเรื่อยๆ มักไม่มีโครงสร้างที่สม่ำเสมอ พอมีบั๊กโผล่มาอีกหกเดือนถัดมา วิศวกรต้องเสียเวลาหลายวันไปแกะโค้ดที่ไม่มีใครเข้าใจ
- ค่าตามแก้ความปลอดภัย ถ้าไม่มีระบบ eval อัตโนมัติ การผลิตโค้ดเร็วก็คือการผลิตช่องโหว่เร็ว และค่าแก้ช่องโหว่ตอนขึ้น production แพงกว่าตอนออกแบบหลายเท่า
agentic engineering = CapEx สูง OpEx ต่ำ ต้องลงแรงก่อนตั้งแต่ยังไม่มีโค้ด production สักบรรทัด ทั้งออกแบบ API schema สร้างชุดเทสต์ และจัดโครงสร้างบริบทให้ agent แลกมากับต้นทุนส่วนเพิ่มของการส่งฟีเจอร์และดูแลระบบที่ต่ำลงมาก
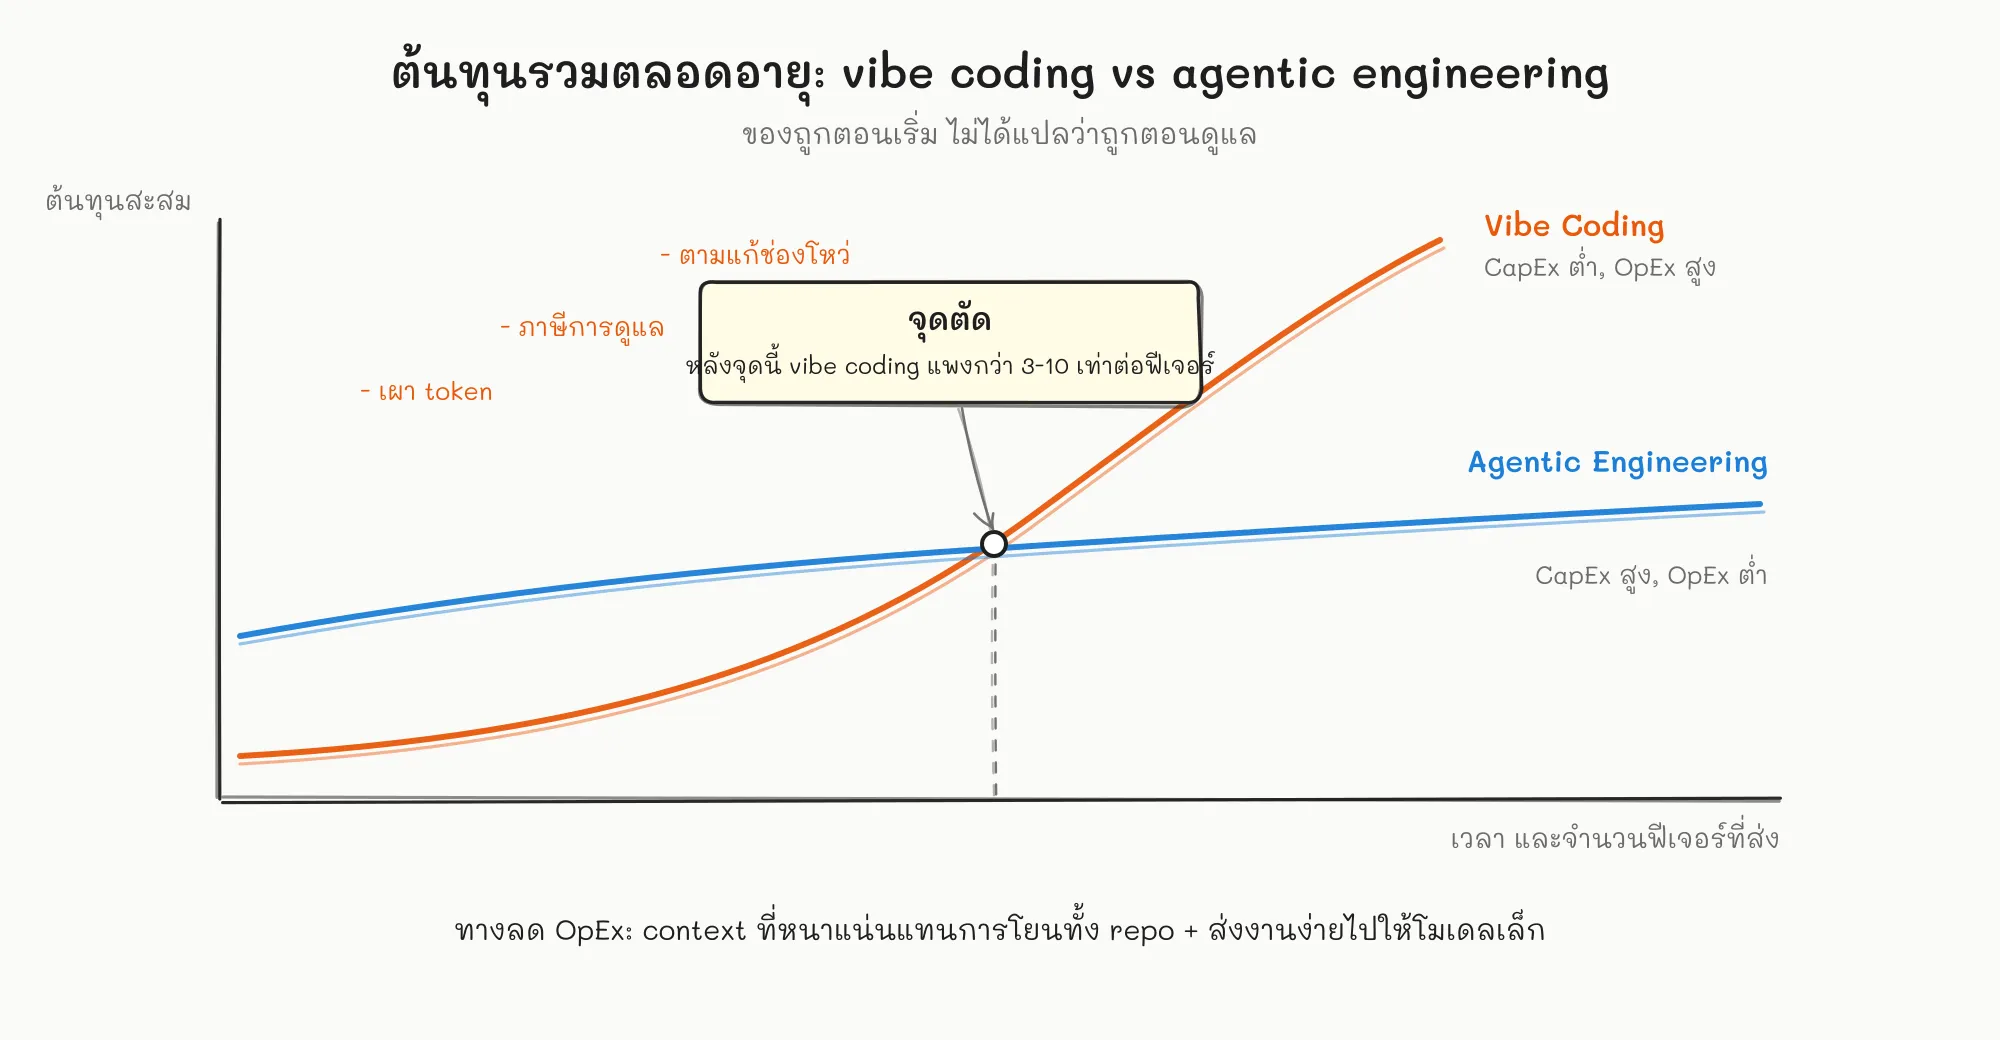
กราฟในเล่มมี จุดตัด อยู่จุดหนึ่ง ก่อนถึงจุดนั้น vibe coding ได้เปรียบเรื่องความเร็วถึงผลลัพธ์แรก แต่หลังจุดนั้นไปเขาระบุว่า vibe coding มีต้นทุนต่อฟีเจอร์แพงกว่า 3 ถึง 10 เท่า ซึ่งตรงกับความรู้สึกของคนที่เคยเอาต้นแบบที่ vibe มาแล้วดันขึ้น production นั่นแหละ
อีกสองกลไกที่เขาชี้ว่าช่วยลด OpEx คือ context engineering ในฐานะเครื่องมือการเงิน (ส่งบริบทที่หนาแน่นและตรงประเด็นแทนที่จะโยนทั้ง repo แสน token เข้าไปทุกครั้ง เพื่อดันอัตราสำเร็จตั้งแต่ครั้งแรกให้สูงขึ้น) กับ model routing (ใช้โมเดลใหญ่กับงานที่ซับซ้อนจริงอย่างสถาปัตยกรรม แล้วส่งงานตายตัวอย่างสร้างเทสต์หรือเฝ้า CI/CD ไปให้โมเดลเล็กที่เร็วและถูกกว่า จะได้ไม่ต้องจ่ายราคาโมเดลเรือธงแค่เพื่อขอให้แก้ typo)
แล้วเริ่มยังไงดี
whitepaper แยกคำแนะนำเป็นสามระดับ ผมหยิบมาเฉพาะข้อที่คิดว่าเอาไปใช้ได้เลย
ถ้าเป็น dev คนเดียว
- ทำไฟล์
AGENTS.md(หรือชื่อที่ agent ของเราใช้) ประจำโปรเจกต์ เริ่มแค่สิบบรรทัดพอ คือ stack, ธรรมเนียมการเขียน, กฎที่ห้ามฝ่าฝืน, workflow แล้วเพิ่มกฎใหม่ทุกครั้งที่ agent ทำอะไรที่ไม่อยากให้ทำซ้ำ - ลงชุด skill ให้ agent ไว้ใช้ซ้ำ แทนที่จะอธิบายวิธีทำเดิมๆ ใหม่ทุกครั้ง
- หยิบงานซ้ำๆ ที่ทำประจำมาหนึ่งอย่างแล้วทำให้เป็น agent ตัวแรก เขาบอกว่าการสร้าง agent ให้จบตั้งแต่ต้นจนดีพลอยหนึ่งตัว สอนได้มากกว่าอ่านเรื่อง agent ร้อยบทความ
- เขียนเทสต์กับ eval ก่อนสั่งให้ generate โค้ด เพราะสองอย่างนี้คือสัญญาที่ทำกับ AI และสื่อเจตนาได้แม่นกว่า prompt ภาษาคน นี่คือเส้นแบ่งที่เปลี่ยนงานจาก vibe coding เป็น agentic engineering จริงๆ
- รีวิวทุกบรรทัดที่จะขึ้นจริง ระแวงโค้ดที่ดูฉลาดเกินไป เช็กว่า import ชี้ไปยังแพ็กเกจที่มีอยู่จริง (ข้อนี้ผมเสริมเอง ในเล่มบอกแค่ว่าให้เช็ก import ว่าเป็นแพ็กเกจจริง แต่ที่ต้องระวังคือมีความเสี่ยงที่โมเดลจะเดาชื่อแพ็กเกจที่ไม่มีอยู่ แล้วมีคนไปจดชื่อนั้นใส่มัลแวร์ดักไว้) และดูว่าการจัดการ error ครอบคลุมสถานการณ์จริง
- รักษาทักษะตัวเองไว้ ให้ AI รับงานประจำเพื่อที่เราจะได้ไปโฟกัสงานยาก แต่ข้อตกลงนี้ใช้ได้ก็ต่อเมื่อพื้นฐานเรายังคม ทั้งการดีบั๊ก การออกแบบระบบ และสัญชาตญาณเรื่องความถูกต้อง
ถ้าเป็นหัวหน้าทีม ให้ยก context engineering ขึ้นเป็นงานวิศวกรรมชั้นหนึ่ง คือปฏิบัติกับ AGENTS.md, system prompt, ชุด eval และคลัง skill เหมือนโค้ด มีคนรีวิวใน PR มีเวอร์ชัน มีเจ้าของชัดเจน ไม่งั้น harness จะค่อยๆ เพี้ยนจนพฤติกรรม agent ของแต่ละคนในทีมไม่เหมือนกัน อีกข้อที่ผมชอบคือ ตั้งมาตรฐานที่ eval ไม่ใช่ที่ demo เพราะ demo พิสูจน์แค่ว่ามันเคยทำสำเร็จหนึ่งครั้ง ส่วน eval ที่ผ่านคือหลักฐานว่ามันทำสำเร็จได้อย่างสม่ำเสมอ และต้องแยกให้ชัดด้วยว่างานไหนคือการทดลอง งานไหนคือของขึ้นจริง ทีมที่ปล่อยให้เส้นนี้เบลอจะได้ต้นแบบที่ขึ้น production โดยอุบัติเหตุ
ถ้าเป็นระดับองค์กร ให้มองว่านี่คือการลงทุนเชิงวิศวกรรม ไม่ใช่ฟีเจอร์เพิ่ม productivity เพราะทีมที่ได้ผลมากที่สุดคือทีมที่จับคู่เครื่องมือ AI เข้ากับ eval coverage, observability และมาตรฐานสถาปัตยกรรมที่ชัด การแจก coding agent ให้ทุกคนโดยไม่มีโครงรองรับ ได้ความเร็วมาโดยไม่ได้คุณภาพ แล้วมันจะกลายเป็นหนี้ทางเทคนิคที่โตเร็วกว่าที่ทีมไหนจะใช้คืนไหว
ของฟรีไม่มีในโลก: สิ่งที่ต้องระวัง
whitepaper กับงานวิจัยที่เกี่ยวข้องไม่ได้เชียร์อย่างเดียว แต่เตือนข้อควรระวังไว้ด้วย ซึ่งผมว่าสำคัญพอๆ กับข้อดี:
- ความปลอดภัย ถ้าโยนโค้ดเข้าโมเดลสาธารณะมั่วๆ อาจมี access key หรือข้อมูลสำคัญหลุดออกไปได้ ต้องมีแซนด์บ็อกซ์และนโยบายเข้าถึงข้อมูลที่ชัดเจน (CSA มีรายงานเรื่องนี้โดยเฉพาะ)
- หลุดจากการควบคุม ถ้าไม่มีด่านตรวจ pipeline อาจค่อยๆ เพี้ยนออกจากสถาปัตยกรรมที่ตั้งใจไว้
- ทักษะฝ่อ พอ AI ทำง่ายกว่า เราอาจหยุดพัฒนาตัวเอง ทีมต้องจงใจใส่ “การเรียนรู้” กลับเข้าไปในกระบวนการ
- คุณภาพโค้ด โค้ดที่ AI หลายตัวช่วยกันเขียน อาจไม่สม่ำเสมอหรืออ่านยาก ถ้าไม่มีมาตรฐานคุม
- โค้ดที่ “ดูถูกต้อง” อันตรายที่สุดไม่ใช่โค้ดที่พังให้เห็น แต่คือโค้ดที่ผ่านเทสต์พื้นฐานแล้วแอบผิดตรงสมมติฐานทางธุรกิจ ซึ่งเจอตอนขึ้น production ไปแล้ว
อยากอ่านเชิงวิชาการเพิ่มลองดู A Survey of Vibe Coding with Large Language Models ที่รวมงานวิจัยด้านนี้ไว้ค่อนข้างครบ
สามหลักการที่เหลืออยู่เมื่อเครื่องมือเปลี่ยนไป
ตอนปิดเล่มเขาสรุปเป็นสามข้อที่บอกว่าจะยังจริงอยู่แม้เครื่องมือจะเปลี่ยนไปอีกกี่รอบ
- โครงสร้างสเกลได้ แต่ vibe สเกลไม่ได้ vibe coding ใช้ได้จริงกับการสำรวจ ทำต้นแบบ และงานส่วนตัว แต่กับซอฟต์แวร์ที่องค์กรต้องพึ่งพา วินัยแบบ agentic engineering ไม่ใช่ตัวเลือก เพราะช่องว่างระหว่าง “ดูเหมือนจะใช้ได้” กับ “ถูกต้องในทุกเงื่อนไข” คือจุดที่ระบบล่ม ช่องโหว่ และฝันร้ายเรื่องการดูแลมักเกิดขึ้น
- AI ขยายวัฒนธรรมวิศวกรรมที่มีอยู่เดิม องค์กรที่เทสต์ดี มีมาตรฐานสถาปัตยกรรมชัด และรีวิวโค้ดกันจริงจัง จะได้ประโยชน์จาก AI มากกว่าที่อื่นแบบทิ้งห่าง เพราะ AI เป็นตัวคูณ และมันคูณทั้งจุดแข็งและจุดอ่อน
- บทบาทของคนกำลังเปลี่ยน ไม่ใช่กำลังหายไป คนที่เข้าใจสถาปัตยกรรม เขียนสเปกได้แม่น ประเมินผลลัพธ์เป็น และออกแบบระบบข้อจำกัดกับ feedback loop ได้ มีค่ามากกว่าเดิม
ส่วนตัวผมว่า vibe coding ไม่ใช่เรื่อง “AI มาแทนโปรแกรมเมอร์” แบบที่คนชอบขู่กัน แต่มันเลื่อนงานของเราขึ้นไปอีกชั้น จากคนแปลความคิดเป็นโค้ดทีละบรรทัด เป็นคนที่ต้องคิดให้ชัดว่าจะสร้างอะไรและทำไม ซึ่งจริงๆ เป็นส่วนที่ยากและสำคัญกว่ามาตลอดอยู่แล้ว ประโยคปิดเล่มของเขาสรุปได้คมกว่าที่ผมจะเขียนเองอีก คือ การผลิตโค้ดเป็นเรื่องที่แก้ไปแล้ว สิ่งที่เป็นงานฝีมือของยุคนี้คือการตรวจสอบ วิจารณญาณ และการชี้ทิศทาง
ใครสนใจอ่านตัวเต็มแนะนำให้ไปโหลด whitepaper มาอ่านเองคับ มีไดอะแกรมประกอบเยอะและมีเชิงอรรถอ้างอิงครบทุกตัวเลขที่ผมยกมา